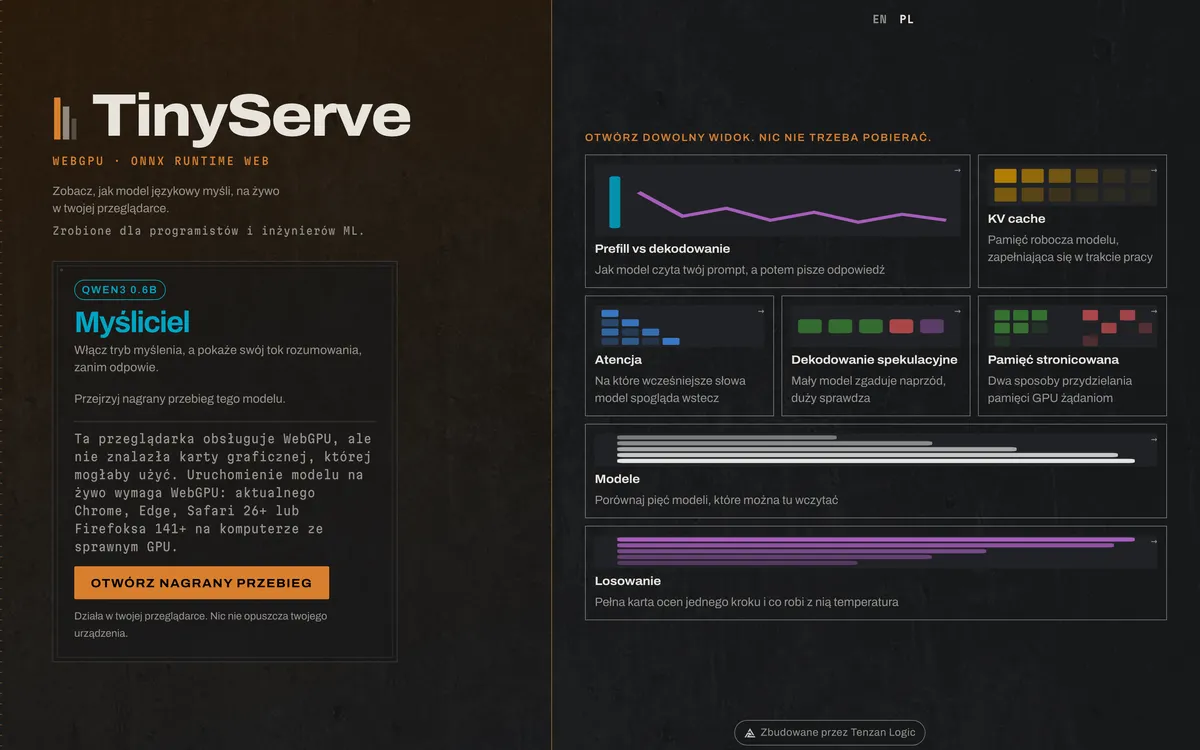
Ekran, który zobaczysz po otwarciu: kafelki z widokami, od prefill i dekodowania po mapy uwagi i losowanie tokenu.
Wyzwanie
LLM to czarna skrzynka, nawet dla inżynierów
Zespoły wdrażające AI często pytają: czemu długi prompt liczy się szybko, a odpowiedź powstaje wolno? Czemu pamięć karty graficznej kończy się przy dłuższej rozmowie? Slajdy i diagramy z artykułów tego nie tłumaczą. TinyServe pokazuje te mechanizmy na żywo, na prawdziwym modelu, bez serwera i bez instalacji.
Jak to działa
Pięć mechanizmów inferencji, widocznych na żywo
Prefill i decode
Dwie fazy inferencji renderowane osobno: dlaczego długi prompt liczy się szybko (prefill, równolegle), a generowanie tekstu jest wolniejsze (decode, token po tokenie).
KV cache
Wykres pamięci rosnącej z każdym tokenem, na tle budżetu, jaki daje okno kontekstu: widać dokładnie, ile pamięci GPU zużywa dłuższa rozmowa.
Mapy uwagi
Cieplna mapa uwagi per warstwa i głowica: które wcześniejsze tokeny model faktycznie bierze pod uwagę, generując następny.
Spekulacyjne dekodowanie i pamięć stronicowana
Mały model proponuje token, duży go przyjmuje albo odrzuca (przyspieszenie bez utraty jakości); osobno symulacja alokatora bloków pamięci (jak w vLLM) kontra alokacja ciągła, z wizualizacją zapchania pamięci.
Losowanie następnego tokenu
Pełna karta ocen jednego kroku: prawdopodobieństwa, z których model wybierał następny token, i co robi z nimi temperatura.
Liczby
Prawdziwy model, nie animacja na pokaz
Rozmowa nie opuszcza Twojego komputera.
5
modeli przełączasz na żywo (Qwen3 0.6B i 1.7B, Llama 3.2, LFM2.5 1.2B, DeepSeek-R1) i porównujesz ich zachowanie na własne oczy.
552 MB
waży najmniejszy z modeli (Qwen3 0.6B): rozmiar mierzony z repozytorium przed pobraniem, nie szacowany. Druga wizyta startuje z cache przeglądarki.
0
zapytań do serwera podczas generowania: wszystko liczy się na Twoim komputerze, więc nic nie wycieka na zewnątrz.
Narzędzie dla programistów i inżynierów ML. Projekt własny. Zbudowaliśmy go i utrzymujemy sami. Model pobiera się raz, a potem liczy u Ciebie.